
Por que uma IA pode ser precisa e ainda assim injusta, segundo ex-CTO da IBM
Fundador da IntegrityFirst.ai alerta que empresas usam testes de viés superficialmente e explica como algoritmos transformam desigualdades históricas em decisões automatizadas
RESUMO +
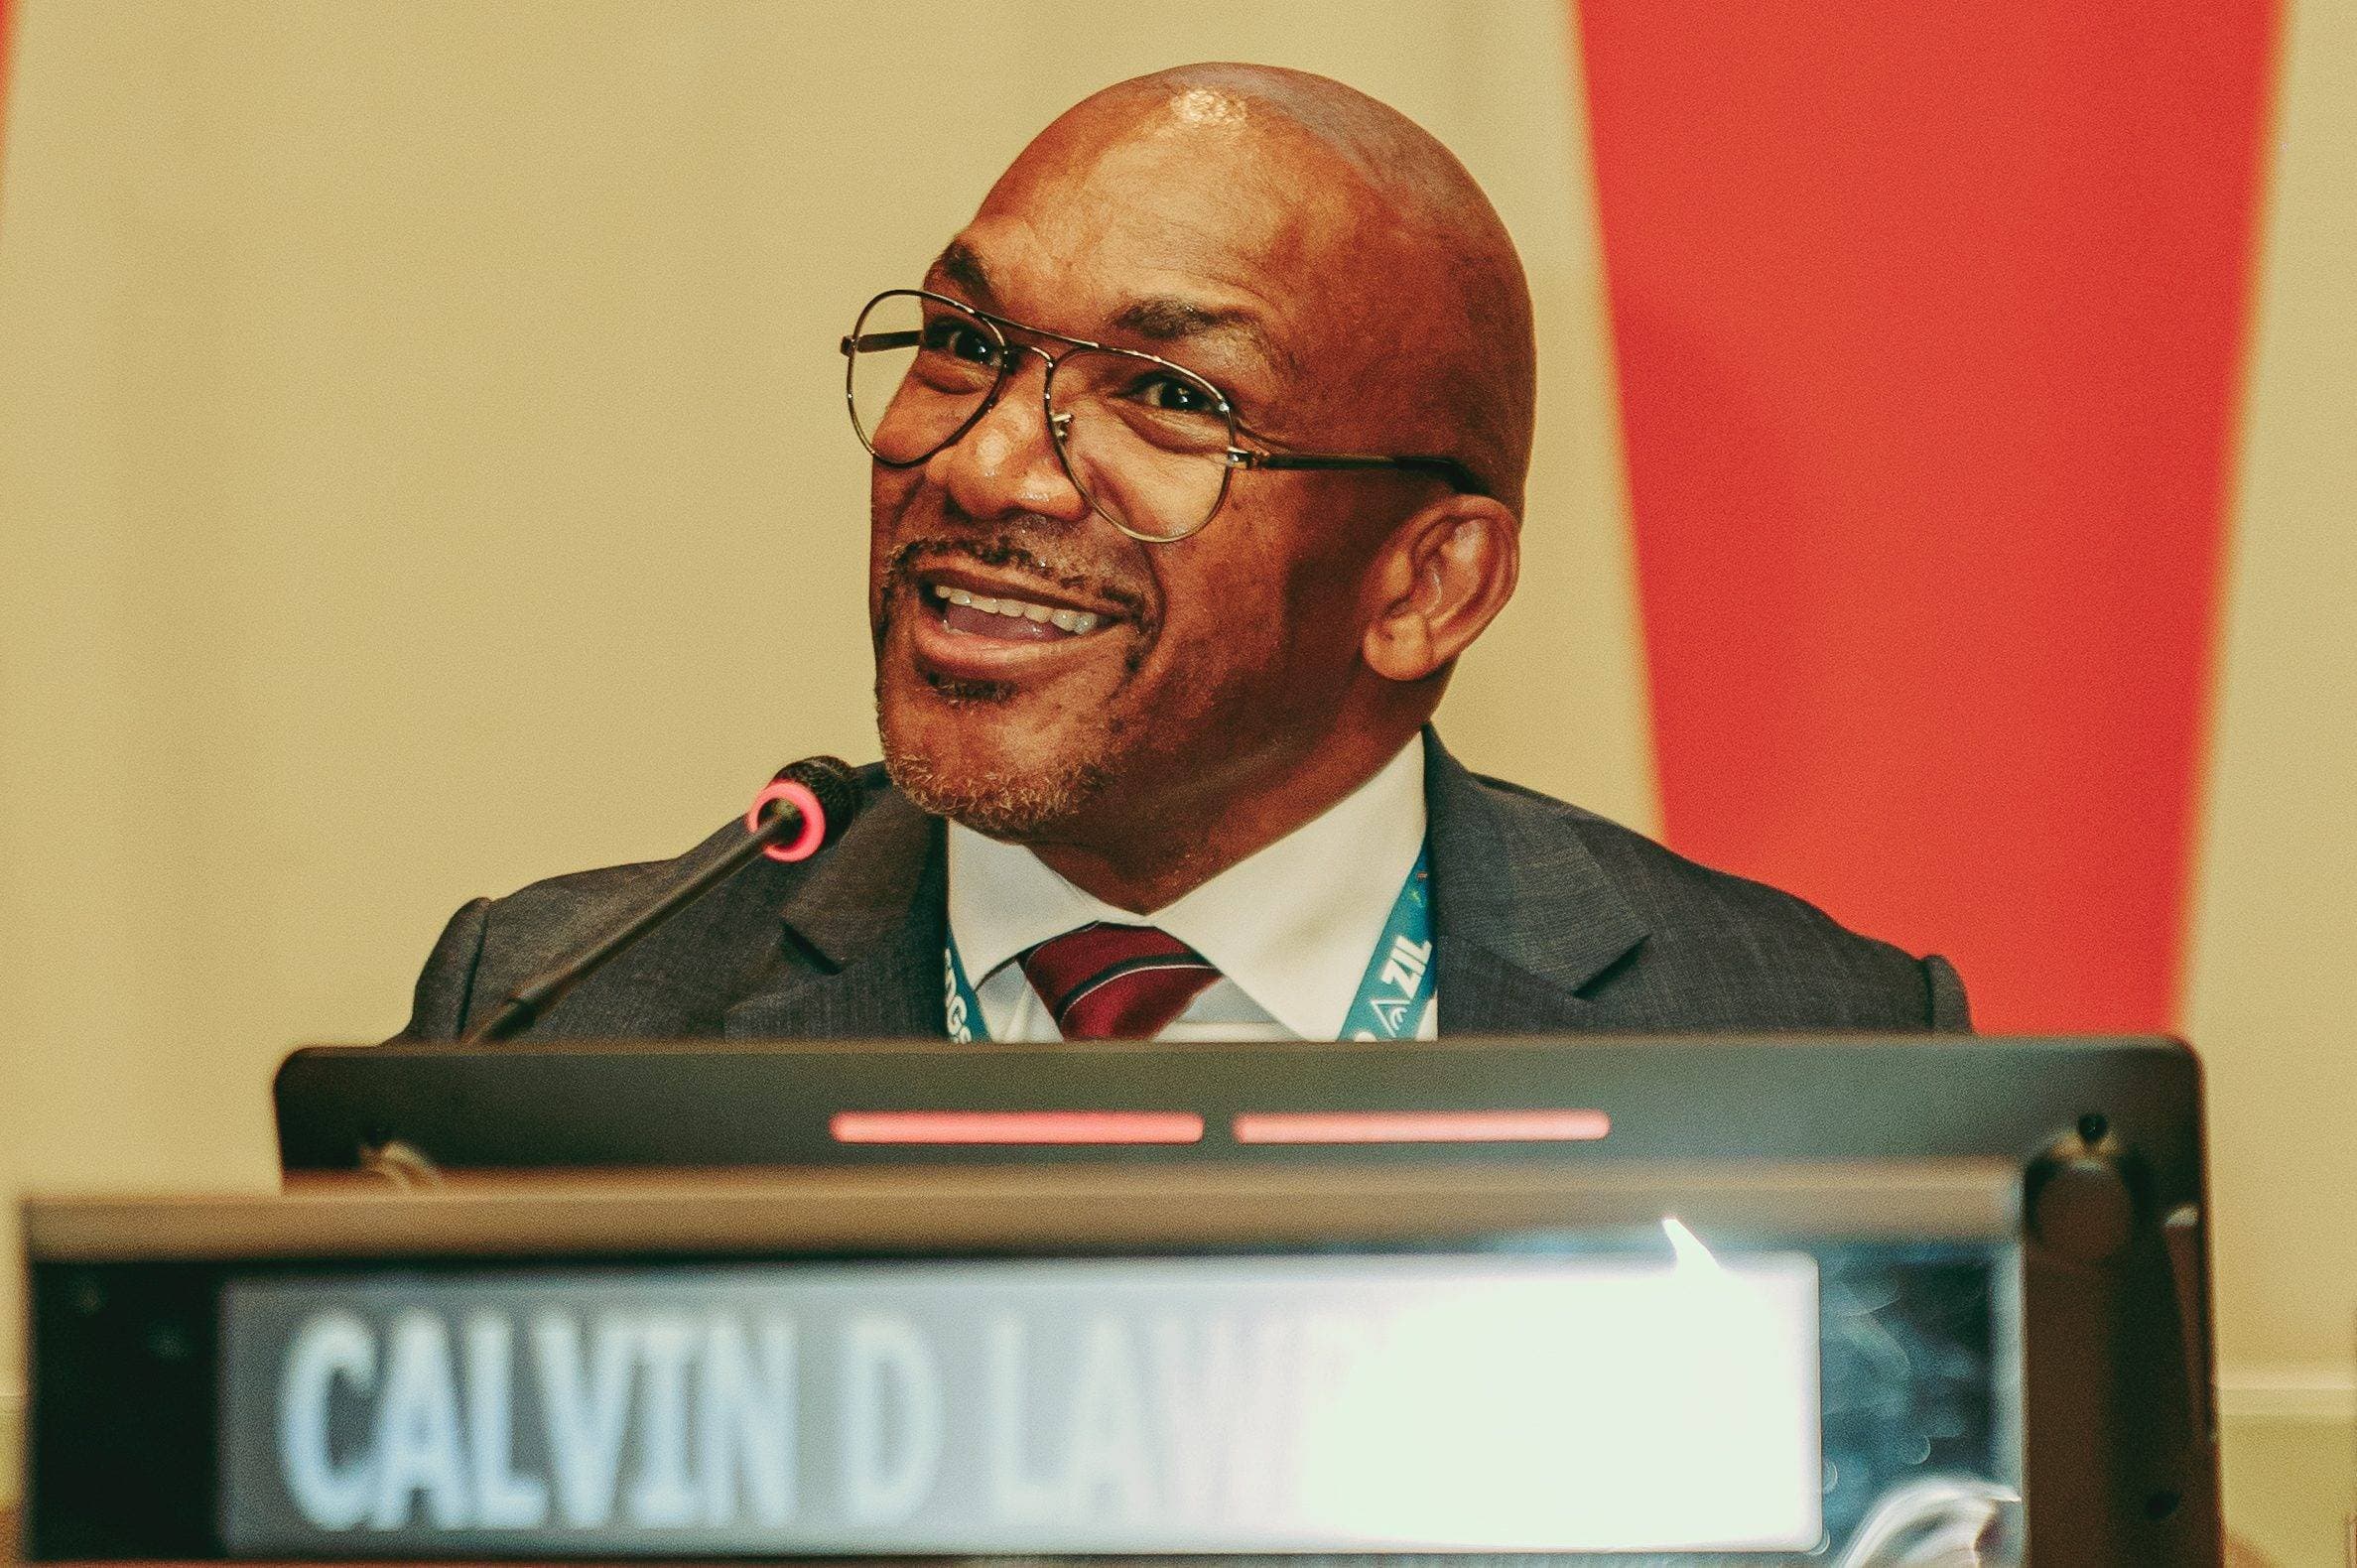
Calvin Lawrence, ex-CTO de IA responsável e confiável da IBM, afirma que sistemas de inteligência artificial podem automatizar desigualdades históricas mesmo sem usar diretamente dados como raça. Fundador da IntegrityFirst.ai, ele defende testes de viés por grupos, revisão humana de decisões automatizadas e monitoramento contínuo de sistemas de alto impacto.
Quando Calvin Lawrence começou a trabalhar com inteligência artificial responsável, discutir princípios e criar diretrizes parecia parte da solução. Depois de 25 anos na IBM — quatro deles no conselho de ética em IA e, por último, como CTO de IA responsável e confiável —, ele chegou à conclusão de que identificar os riscos não bastava. Na verdade, segundo ele, era preciso testar como os sistemas se comportavam no mundo real e acompanhar quem poderia ser prejudicado por suas decisões.
Em 2025, Lawrence deixou a IBM para fundar a IntegrityFirst.ai. A empresa desenvolve a XTegrity, plataforma criada para identificar potenciais danos de sistemas de IA, testar riscos, medir a exposição financeira e de negócio das empresas e auditar modelos já em operação.
Parte dessa preocupação vem de uma questão que acompanha sua carreira: um sistema pode apresentar bons índices de precisão e, ainda assim, produzir resultados muito diferentes entre grupos. “É preciso perguntar: preciso para quem? Errado para quem? E quem paga o preço quando o modelo erra?”, afirmou Lawrence, em entrevista à EXAME.
Autor de 'Hidden in White Sight: How AI Empowers and Deepens Systemic Racism', Lawrence também investiga como desigualdades históricas podem reaparecer em decisões automatizadas, mesmo quando características como raça são retiradas dos dados. Para ele, enfrentar o problema exige testar resultados por grupos, manter revisão humana em decisões de alto impacto e monitorar os sistemas depois da implementação.
EXAME: Depois de 25 anos na IBM, o que exatamente a IntegrityFirst.ai faz, e qual lacuna do mercado de IA responsável fez você deixar o cargo para fundá-la?
A IntegrityFirst.ai ajuda empresas a identificar e gerenciar os riscos reais da IA. Nossa plataforma, a XTegrity, foi feita para ir além de documentar políticas. Ela ajuda organizações a encontrar potenciais danos, testá-los, medir a exposição financeira e de negócio, auditar sistemas de forma independente e governar a IA depois que ela é implementada.
Depois de 25 anos na IBM, incluindo quatro no conselho de ética em IA e como CTO de IA responsável, eu via uma lacuna clara: as empresas tinham muitos princípios e frameworks. O que faltava eram ferramentas práticas para mostrar onde um sistema de IA pode causar dano e o que estão fazendo a respeito. Não saí da IBM para continuar falando sobre IA responsável. Saí para construir isso.
EXAME: Existiu um momento específico que te fez perceber que a IA pode aprofundar ativamente o racismo estrutural, e não só refletir um viés já existente?
Provavelmente não foi um momento único, mas uma sequência deles. Um em especial me vem à mente. Aconteceu enquanto eu trabalhava num sistema ligado a decisões de reincidência e liberdade condicional antecipada. O modelo usava prisões anteriores como previsor de reincidência.
No papel, parece razoável: alguém com dez prisões parece mais arriscado do que alguém com três. Mas a pergunta real é: por que essa pessoa foi presa dez vezes? Se uma comunidade foi policiada de forma mais agressiva do que outra, o histórico de prisões não está medindo só comportamento — está medindo também padrões de policiamento.
Naquele caso, os dados de prisão estavam prontamente disponíveis, enquanto os dados de condenação ficavam armazenados em outro lugar. Então o sistema podia acabar tratando o contato com a polícia como evidência de risco criminal. Foi um dos pontos de virada para mim. O algoritmo não estava inventando racismo. Estava pegando os efeitos da desigualdade histórica, transformando-os em números e usando esses números para moldar o futuro.
EXAME: No livro "Hidden in White Sight", qual exemplo de viés algorítmico em policiamento ou no sistema judicial a maioria das pessoas jamais suspeitaria que existe?
Histórico de prisões anteriores. As pessoas ouvem "dez prisões anteriores" e presumem que isso é um fato objetivo. Mas uma prisão não é uma condenação, e dados de prisão não dizem nada sobre o quão pesadamente diferentes comunidades foram policiadas.
Agora alimente décadas desses dados num modelo e peça para ele identificar pessoas ou bairros de alto risco.
O sistema pode aprender: a polícia esteve aqui ontem, então a polícia deveria estar aqui amanhã. Aí o policiamento de amanhã produz mais prisões, essas prisões viram novos dados, e o modelo parece confirmar a si mesmo. Esse é o loop de retroalimentação. O viés pode ser automatizado sem que ninguém jamais escreva uma linha de código racista.
EXAME: Você propõe uma "carta de direitos da IA" no livro. Na prática, como funcionaria o primeiro item concreto dessa lista?
O primeiro direito é direto: você deveria ter o direito de saber quando a IA afeta materialmente uma decisão sobre sua vida. Se a IA influencia se você consegue uma hipoteca, um emprego, um plano de saúde, um seguro ou até atenção policial, você deveria ser informado.
Mas a transparência é só o começo. Você também deveria poder perguntar por que a decisão foi tomada, corrigir informações incorretas e obter uma revisão humana significativa.
Construímos sistemas capazes de tomar decisões em escala enorme. Direitos humanos não podem desaparecer só porque a decisão foi tomada por um algoritmo em vez de uma pessoa.
EXAME: Quando uma empresa diz que "testou seu sistema de IA contra viés", que perguntas revelam se esse teste foi de fato significativo?
Eu perguntaria: viés contra quem, medido como e usando quais dados? "Testado contra viés" soa bem, mas não é uma resposta significativa por si só. Quais populações foram testadas? Os resultados foram separados por raça, gênero, idade e outras características relevantes? Grupos interseccionais foram incluídos?
Quais eram as taxas de falso positivo e falso negativo para cada grupo? Os dados eram representativos das pessoas que vão de fato usar o sistema ou ser afetadas por ele? E o que a empresa fez depois de encontrar uma disparidade? Testar sem corrigir é só papelada.
EXAME: É possível um sistema de IA ser tecnicamente "preciso" e, ao mesmo tempo, injusto?
Com certeza. Um modelo pode ter 95% de acerto no geral e ainda ter desempenho ruim para uma população específica. Imagine um banco de dados com 10 mil pessoas, das quais 9 mil pertencem a um grupo.
O modelo tem desempenho excelente para essas 9 mil e ruim para as mil restantes. A taxa de acerto geral ainda parece impressionante.
É por isso que as médias podem esconder danos. É preciso perguntar: preciso para quem? Errado para quem? E quem paga o preço quando o modelo erra? É daí que a IA responsável começa.
EXAME: Entre policiamento, saúde, crédito e contratação, qual setor você considera mais exposto hoje a um viés de IA sem controle?
Eu não os classificaria por setor. Eu os classificaria pelas consequências da decisão. Os sistemas de maior risco são aqueles que podem afetar a liberdade, a saúde, a oportunidade econômica ou os direitos fundamentais de alguém.
Isso inclui policiamento e justiça criminal, porque um algoritmo pode influenciar se alguém perde a liberdade. Inclui saúde, porque uma previsão ruim pode afetar diagnóstico ou tratamento. Inclui crédito, porque o acesso a capital pode determinar se alguém compra uma casa, abre um negócio ou constrói patrimônio. E inclui contratação, porque a IA determina cada vez mais quem tem acesso a oportunidades.
A regra é simples: quanto maior o dano potencial, mais forte precisa ser a governança.
EXAME: Como você rebate o argumento de que remover raça ou dados demográficos de um modelo já o torna livre de viés?
Esse é um dos mitos mais persistentes da IA. Você pode remover a raça de um conjunto de dados e ainda reconstruí-la a partir do CEP, da escola frequentada, da renda, do valor do imóvel, do histórico de emprego, do histórico de prisões ou do uso de serviços de saúde.
Até variáveis aparentemente inofensivas podem virar proxies poderosos quando combinadas. Apagar a coluna chamada "raça" não torna um modelo neutro em relação a ela. Na verdade, dados demográficos costumam ser necessários para detectar discriminação.
Se você se recusa a medir resultados por grupo, como vai saber se o sistema trata os grupos de forma diferente? Não é possível combater a discriminação se você se recusa a procurá-la.
EXAME: Para uma empresa de médio porte sem equipe dedicada à ética em IA, qual seria um primeiro passo prático, ainda este ano, para reduzir o risco de viés?
Comece com um inventário. Antes de comprar mais uma plataforma ou escrever uma política de 100 páginas, identifique todo sistema de IA que toma ou influencia materialmente uma decisão sobre uma pessoa. Depois faça cinco perguntas: quem é afetado? Que decisão o sistema influencia? Quais dados o movem? O que acontece quando ele erra? Quem é responsável?
Esse exercício vai mostrar rapidamente onde estão os maiores riscos. IA responsável não precisa começar com um programa gigantesco. Começa sabendo onde sua IA pode afetar a vida de alguém.
EXAME: A regulação de IA, nos Estados Unidos e no mundo, está acompanhando o ritmo de adoção da tecnologia ou ficando cada vez mais para trás?
O cenário é desigual, mas, no geral, a regulação ainda está atrás da implantação.
A Europa avançou de princípios para implementação. Desde 2 de agosto de 2026, partes significativas do AI Act, o regulamento europeu de IA, estão em vigor, incluindo obrigações de transparência e exigências para modelos de propósito geral, enquanto regras adicionais para sistemas de alto risco ainda estão sendo implementadas em fases.
Não é perfeito, mas não precisa ser. Os Estados Unidos são diferentes. Temos expertise técnica tremenda, pesquisadores fortes, reguladores, leis de direitos civis e instituições que entendem muitos desses riscos. Mas ainda não temos uma lei federal abrangente sobre IA.
Parte do desafio é político — talvez a maior parte, talvez tudo. Há divergência real nos Estados Unidos sobre o quão agressivamente o governo deveria regular a IA, quanta responsabilidade deveria ficar com a indústria, e como a autoridade federal e estadual deveriam interagir. Muitos argumentam que regular a IA faria os EUA ficarem atrás da China e da Rússia.
Considero esse argumento sem sentido. Por que competir com nações que parecem dar menos ênfase aos direitos humanos? Não acredito que os Estados Unidos estejam atrás porque não entendemos o problema. Estamos atrás porque nosso sistema político ainda não converteu esse entendimento em proteções consistentes e aplicáveis para as pessoas afetadas pela IA.
O Brasil também é central nesse debate. Embora eu não saiba muito sobre como a política afeta a posição do Brasil sobre regulação de IA, acredito que seu principal marco regulatório, o PL 2338/2023, foi aprovado pelo Senado e segue em análise na Câmara dos Deputados. O problema básico é o mesmo em todo lugar: empresas conseguem implantar IA muito mais rápido do que governos conseguem legislar.
É por isso que as empresas precisam governar esses sistemas antes que um regulador diga exatamente como fazê-lo.
EXAME: O que te levou a fundar também a AI 4 Black Kids, e que mentalidade você tenta passar a essas crianças que a educação tecnológica tradicional não oferece?
Para ser sincero, quem me inspirou fui eu mesmo. Lembrando daquele garoto de 12 anos que não teve a chance de tocar um computador até chegar à faculdade. E como fui treinado para ser um consumidor e usuário de tecnologia, não um criador.
Não quero que crianças negras aprendam apenas a usar a IA de outra pessoa. Quero que entendam que podem construí-la, questioná-la e ser donas dela. Aprender a programar e usar tecnologia importa, mas não basta. Quero crianças perguntando: por que o sistema tomou essa decisão? Que suposições entraram nela? Quem pode estar sendo excluído? Eu poderia construir algo melhor? Também quero que pensem em empreendedorismo e propriedade intelectual.
Quando uma criança percebe "eu posso inventar algo que não existia ontem", a relação dela com a tecnologia muda. Ela para de se ver só como usuária. Começa a se ver como criadora.
EXAME: Corrigir o viés em uma parte de um sistema já criou, na sua experiência, um problema novo e inesperado em outra parte?
Com certeza. É por isso que a justiça não pode ser reduzida a uma única métrica. Você pode melhorar uma medida de justiça e piorar outro resultado. Mude o limiar de decisão de um sistema, por exemplo, e você pode reduzir falsos positivos para um grupo enquanto aumenta falsos negativos para outro. Você também pode melhorar a paridade geral enquanto esconde um desempenho ruim para um subgrupo interseccional menor.
Não existe um botão mágico de "remover viés". Esses sistemas envolvem trocas que precisam ser monitoradas continuamente. Justiça, explicabilidade, transparência, incerteza e qualidade precisam ser avaliadas juntas, e monitoradas depois da implantação, não só antes dela.
EXAME: Qual o risco de sistemas de IA treinados majoritariamente com dados de países ricos serem implantados globalmente, inclusive em um país como o Brasil?
É uma preocupação séria porque a IA é contextual. Um modelo treinado principalmente com dados dos Estados Unidos ou da Europa Ocidental aprendeu algo sobre essas populações, instituições, idiomas, economias e comportamentos.
Isso não torna suas conclusões universais. O Brasil é um bom exemplo. Tem uma diversidade racial, geográfica, socioeconômica e cultural enorme. Um modelo pode ter um desempenho muito diferente em São Paulo, em Salvador, na região amazônica ou em uma comunidade rural. Localização não é só traduzir uma interface para o português. As empresas precisam perguntar se os dados representam as pessoas afetadas, se as suposições atravessam culturas, e se o sistema foi validado localmente. Caso contrário, corremos o risco de exportar algoritmos pelo mundo mantendo embutidas as suposições das sociedades que os construíram.
EXAME: Se você pudesse decretar uma única mudança para toda a indústria de IA amanhã, qual seria?
Antes que um sistema possa tomar decisões consequentes sobre pessoas, a organização deveria responder: quem esse sistema poderia prejudicar? Como vocês testaram esse dano? Que evidência vocês têm? O que acontece quando algo dá errado? Quem é responsável?
Hoje, muitas vezes implantamos primeiro e investigamos o dano depois. Para sistemas de alto impacto, essa ordem precisa ser invertida. As pessoas não deveriam ter que se tornar vítimas de um algoritmo antes que alguém verifique se ele é seguro.
EXAME: Olhando cinco anos à frente, você está mais esperançoso ou mais preocupado com os rumos da indústria em relação a viés e responsabilização em IA?
Estou esperançoso, mas não confortável. Cinco anos atrás, eu ainda gastava muito tempo explicando que o viés algorítmico era um problema real. Hoje, conselhos de administração, executivos, reguladores e empresas de tecnologia discutem isso a sério. Isso é progresso.
Minha preocupação é com o ritmo. A IA avança muito mais rápido do que a maioria das organizações consegue governar. Sistemas generativos e agênticos também estão criando novas categorias de risco.
O cavalo da IA já saiu do celeiro. Não estamos mais decidindo se a IA vai fazer parte da sociedade. Ela já faz. A questão é se a responsabilização, a transparência e a proteção aos seres humanos vão escalar tão rápido quanto a tecnologia. Acredito que sim. Mas isso não vai acontecer automaticamente.